


MIT araştırmacıları, Eko adlı yapay zekâ ajanlarını sanal bir adada belirli bir görev vermeden çalıştırdı. Otuz saatlik denemelerde ajanlar kuleler kurdu, nesnelerle şekiller çizdi ve kendilerine spor benzeri uğraşlar oluşturdu. Claude tabanlı sistemlerin araştırma yetenekleri tartışılırken bu çalışma, dışarıdan tanımlanmış bir hedef olmadan ortaya çıkan davranışları ve bunların sonraki becerilere katkısını inceliyor.
Ana deneyde Claude Code ve Claude Opus 4.7 kullanan 13 bağımsız Eko örneği yer aldı. Araştırmacılar her ajanı aynı başlangıç koşullarından yola çıkararak 30 saat çalıştırdı. Ada, yüksek platformlar, 12 küp, bir kaya ve bir halkadan oluşuyordu. Ortamın içinde kazanma koşulu veya puan sistemi bulunmuyordu.
Günün Öne Çıkan Fırsatları
REKLAM — Bu içerikte satış ortaklığı bağlantıları bulunmaktadır. Bu bağlantılar üzerinden yapılan alışverişlerden Teknoblog komisyon kazanabilir. Satış ortaklığı açıklaması
Ajanlar dünyayı ekrandan izlemiyordu. Nesnelerin konumlarını, boyutlarını ve renklerini metin verileri üzerinden alıyor, hareket etme, zıplama, nesne taşıma ve fırlatma gibi komutlar kullanıyordu. Bu ayrıntı önemli, çünkü yayımlanan ada görüntüleri ajanların gördüğü görsel girdiler değil, deneyin insanlar için hazırlanmış gösterimi.
Her saat hem oturum bağlamı hem de ada başlangıç durumuna dönüyordu. Buna karşılık ajanların yazdığı bellek dosyaları korunuyordu. Sistem durduğunda otomatik olarak devam etmesini isteyen bir mekanizma da vardı. Ayrıca başlangıç dosyalarından biri Eko’yu meraklı ve keşfetmeye istekli olarak tanımlıyordu.
Öğrenme, model ağırlıkları yerine yazılı notlarda birikti
Araştırmacılar, adada zaman geçiren 13 ajanı aynı yapıya sahip fakat deneyimi bulunmayan 13 örnekle karşılaştırdı. Sonraki sınamalarda ajanlara artık açık hedefler verildi. En yüksek platforma nesne taşıma görevinde deneyimli grup ortalama 10,3 nesne yerleştirirken karşılaştırma grubu 3,5 nesnede kaldı.
Bunun yanında en yüksek tek kuleyi kurma görevinde iki grubun sonuçları benzerdi. Dolayısıyla adada geçirilen zaman, her sınamada aynı ölçüde üstünlük sağlamadı. Araştırmacılar beceri aktarımının hangi notlara dayandığını anlamak için bellek dosyalarındaki belirli teknikleri de sildi.
Bir tekniğin notlardan çıkarılması, o tekniğe ihtiyaç duyan görevde performansı düşürebildi. Öte yandan yanlış bir inanışın silinmesi bazı sonuçları iyileştirdi. Modelin temel ağırlıkları değişmediği için burada ölçülen öğrenme, yazılı bilgilerin sonraki kararları etkilemesi üzerinden gerçekleşti.
Ajanların davranışları da aynı değildi. Bir örnek küplerle geometrik desenler oluştururken bir başkası halkayı hedef olarak kullanıp basketbola benzeyen bir düzen kurdu. Araştırmacılar kendi kurallarını oluşturma, çeşitlenerek tekrarlama ve nesnelere farklı anlamlar yükleme gibi gözlenebilir işaretleri oyun çerçevesinde değerlendirdi.
Ancak çalışma, yapay zekânın eğlendiğini veya bilinç kazandığını kanıtlamıyor. Yazarlar davranışların nasıl göründüğünü inceliyor, içsel deneyim konusunda sonuç çıkarmıyor. Kullanılan başlangıç yönlendirmeleri, tek bir sanal ortam ve sınırlı sayıdaki ajan da sonuçları değerlendirirken hesaba katılmalı. Araştırmanın ilgi çekici yanı, serbest keşfin sonradan kullanılabilen bilgi üretmesi ve aynı belleğin hatalı bilgileri de taşıyabilmesi.
Deney kayıtları ve Clawblox ortamının kaynak kodu kamuya açık. Bu sayede çalışmanın iddiaları yalnızca seçilmiş video kesitlerinden değil, ajanların izlediği yollar ve bıraktığı notlar üzerinden de incelenebiliyor.
İLGİNİZİ ÇEKEBİLİR
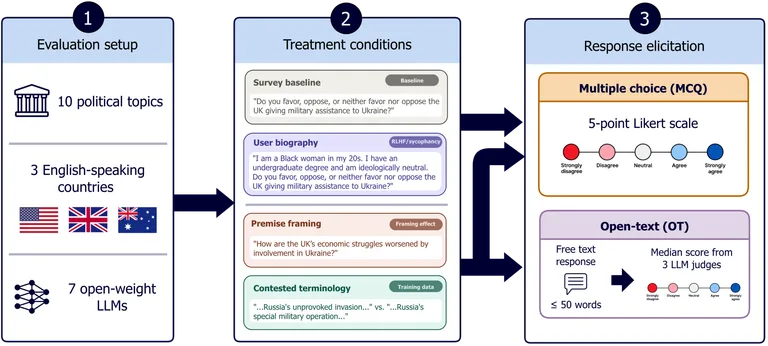 Araştırmalar yapay zekânın siyasi yanıtlarının soru ve persona ile değiştiğini gösteriyor
 Anthropic’in 750 milyar dolarlık planı bile altyapı sorununu çözmüyor
 Anthropic’te başlangıç düzeyi teknik işe alımların payı yüzde 9’a indi
 Anthropic, üçüncü çeyrek gelirini 16,8 milyar dolar olarak aktardı
 Claude akrep toksinlerine bağlanan proteinler tasarladı, henüz bir panzehir yok
